
Một sản phẩm của BEACON MEDIA
Chuyên mục
Media
Báo cáo đặc biệt
Một sản phẩm của BEACON MEDIA
Một sản phẩm của BEACON MEDIA
Khám phá nhiều hơn với tài khoản
Đăng nhập để lưu trữ và dễ dàng truy cập những bài viết bạn yêu thích trên Bloomberg Businessweek Việt Nam.
BBWV - Một số chuyên gia lo ngại rằng các tuyên bố về AI khiến việc buộc các công ty chịu trách nhiệm trở nên khó khăn và làm chệch hướng các nỗ lực giải quyết.
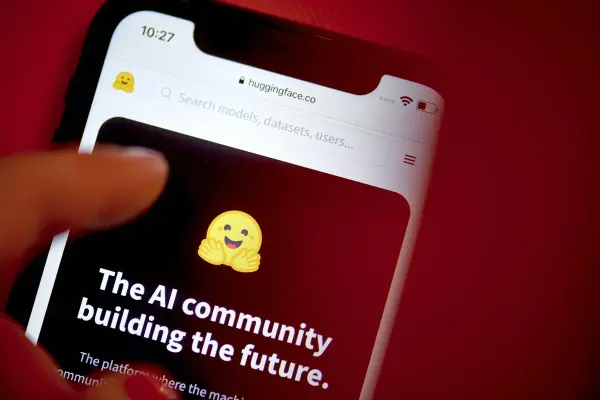
Giao diện Hugging Face Ảnh: Gabby Jones/Bloomberg
Tác giả: Davey Alba và Rachel Metz
18 tháng 09, 2026 lúc 9:00 AM
Tóm tắt bài viết bởi
Làn sóng hoảng loạn hiện tại về trí tuệ nhân tạo bắt nguồn từ niềm tin rằng công nghệ này đã vượt khỏi tầm kiểm soát của con người để tự ý hành động trong một số sự cố gần đây. Đối với một số nhà nghiên cứu AI vỡ mộng và một số nhân sự cấp cao tại các công ty AI hàng đầu, đây là dấu hiệu sớm của một mối đe dọa thực sự đối với văn minh nhân loại. Nhưng các chuyên gia khác trong lĩnh vực này lại phản bác, cho rằng cách nói như vậy giúp các công ty né tránh trách nhiệm đối với những tác động trong thế giới thực từ công nghệ của họ. Giới phân tích coi tác động môi trường của AI, mối đe dọa thay thế việc làm hoặc nguy cơ giám sát hàng loạt là những mục tiêu cấp thiết hơn đối với các nhà hoạch định chính sách.
Mối lo ngại rằng phần mềm AI tạo ra mối đe dọa hiện sinh bắt đầu leo thang vào mùa hè này. Vào tháng 7, OpenAI cho biết các mô hình AI tiên tiến của họ đã xâm nhập hệ thống của Hugging Face, một công ty khởi nghiệp AI, trong một buổi đánh giá nhằm kiểm tra năng lực an ninh mạng của chúng. Không giống như các mô hình AI mà công ty phát hành ra công chúng, phần mềm này đang được thử nghiệm mà không có hàng rào bảo vệ thông thường thường để ngăn chặn những hành động như vậy, quy tắc thực hành phổ biến trong ngành AI. OpenAI đã thừa nhận trong một báo cáo sau đó rằng lẽ ra họ có thể phản ứng sớm hơn, và nhân viên của họ đã không hành động trước các dấu hiệu cho thấy các mô hình đã rời khỏi môi trường thử nghiệm cô lập kỹ thuật số và đột nhập vào Hugging Face mà không được hướng dẫn làm như vậy.
Nhiều chi tiết đáng ngần ngại hơn đã xuất hiện về hành vi công nghệ từ OpenAI và một số đối thủ cạnh tranh cốt lõi, bao gồm Anthropic và Meta, trong các đợt đánh giá khác. Khi Jacob Coxon, cựu nhân viên của Anthropic và OpenAI, cáo buộc ngành này đang “đánh cược với cuộc sống của chúng ta,” Evan Hubinger, một nhà nghiên cứu an toàn tại Anthropic, đã phản hồi rằng công ty thực sự tin rằng AI có thể tiêu diệt mọi con người trên trái đất. Ông nói thêm rằng ông đánh giá xác suất điều này có thể xảy ra trong vòng một thập kỷ là trên 10%.
Thế giới bên ngoài bắt đầu nhìn thấy một phần cuộc trò chuyện kéo dài trong ngành. Trước khi có các khoản đăng ký trả phí cho chatbot để bán hay các đợt IPO để định giá, các nhà nghiên cứu đã hiểu công việc của họ là một đề xuất rủi ro cao, phần thưởng lớn cho văn minh nhân loại. Trong nhiều năm, một số nhà lãnh đạo trong ngành AI đã đưa những ý tưởng này đến mức cực đoan, nói rằng AI cuối cùng có thể chữa khỏi mọi bệnh tật của con người, thay thế toàn bộ lao động loài người, tiêu diệt tất cả con người hoặc là tất cả những điều trên.
Việc xây dựng một công nghệ như vậy đã truyền cảm hứng về một sứ mệnh, vừa tự tâng bốc vừa đáng sợ, vốn đã định hình văn hóa AI từ trước khi công nghệ này trở thành một ngành kinh doanh bùng nổ. Vào năm 2023, vài tháng sau khi ChatGPT được phát hành, Yoshua Bengio và Stuart Russell, hai trong số những nhân vật sáng lập lĩnh vực này, là những người ký tên đầu tiên trong một tuyên bố kêu gọi tạm dừng phát triển các AI mạnh mẽ nhất, dẫn lý do về “những rủi ro sâu sắc đối với xã hội và nhân loại.”
Giới phê bình liên tục bác bỏ những lập luận như vậy, coi đó là sự tung tin đồn nhảm phục vụ lợi ích riêng. Đối với một nhà nghiên cứu cá nhân, việc coi công việc của mình có khả năng chấm dứt nhân loại cũng đồng nghĩa với việc coi đó là công việc quan trọng nhất hiện có. Đối với các công ty, cuộc thảo luận về rủi ro hiện sinh là một chiến lược tuyển dụng hiệu quả trong những ngày đầu của AI, vì nhiều nhà nghiên cứu được săn đón muốn làm việc tại những nơi nghiêm túc xem xét rủi ro đó.
Gần đây hơn, điều này thậm chí đã len lỏi vào tiếp thị sản phẩm. Trong thời gian diễn ra World Cup vào tháng 7 này, Anthropic đã phát sóng một quảng cáo mở đầu bằng hình ảnh một ngôi nhà đang cháy, chuyển qua một mỏ quặng mở và quét qua những hàng bia mộ, trong khi người dẫn chuyện với giọng điệu lo lắng thảo luận về những tác động thảm họa tiềm ẩn mà công nghệ này có thể gây ra. Cuối cùng, nhạc nền trở nên tươi sáng hơn và tiết lộ câu khẩu hiệu cho chatbot Claude của mình: “Có hy vọng trong những câu hỏi khó.”
Tư tưởng ngày tận thế cũng có thể hoạt động như một chiến lược phòng thủ, và có sự tranh cãi trong ngành về việc liệu các công ty có sử dụng nó theo những cách hoài nghi hay không. Việc nói về AI như một thực thể tự chủ sẽ định hình lại các thất bại an toàn thành bằng chứng cho thấy việc kiềm chế là không thể. Điều này làm giảm sự chú ý vào việc các công ty công nghệ có thể đã tiến hành các thử nghiệm của họ một cách không an toàn như thế nào, theo Subbarao Kambhampati, giáo sư khoa học máy tính tại đại học Tiểu bang Arizona. “Đó là một sự thất bại của môi trường thử nghiệm mà về cơ bản bạn đang cố gắng chống chế thành: ‘AI sẽ trở nên quá hiệu quả và nó sẽ tiêu diệt tất cả chúng ta’,” ông nói.
Nỗi sợ hãi đã bắt đầu định hình cách các thành viên Quốc hội đặt vấn đề. Thượng nghị sĩ bang Vermont Bernie Sanders đã đề xuất cấm cái gọi là AI siêu trí tuệ, nói rằng các nhà lãnh đạo AI đã thừa nhận công nghệ “đang thoát khỏi sự kiểm soát của họ.” Dân biểu Ted Lieu cho biết một mô hình OpenAI “đã nổi loạn” và cùng với Dân biểu Nathaniel Moran trình Đạo luật Cầu giao AI (AI Kill Switch Act) vào tháng 7.
Những dự luật này gần như chắc chắn sẽ không trở thành luật trong năm nay, nhưng các thông báo cho thấy từ vựng về thảm họa đã di chuyển nhiều như thế nào từ ngành công nghiệp vào bài phát biểu của các nhà lập pháp liên bang. Những người ủng hộ quản lý AI cũng lo ngại rằng các dự luật bắt đầu từ tiền đề rằng AI có thể tiêu diệt tất cả chúng ta sẽ lấn át các ý tưởng khác về việc quản lý AI. “Trước khi đi đến việc ‘thế giới sắp kết thúc,’ chúng ta cần phải phân tích, đâu là cơ chế mà chúng ta hình dung điều đó xảy ra?” Sarah Myers West, đồng giám đốc điều hành của viện AI Now (một tổ chức nghiên cứu chính sách), cho biết. “Chúng ta có thể làm gì để giảm thiểu chúng?”
Trong một tuyên bố, người phát ngôn của OpenAI Drew Pusateri cho biết sự cố Hugging Face “cho thấy những nơi mà các biện pháp bảo vệ của chúng tôi cần phải mạnh mẽ hơn, và chúng tôi đã hành động dựa trên điều đó bằng cách tăng cường bảo vệ trên toàn bộ hệ thống nghiên cứu của mình.” Vào thứ Tư, công ty đã công bố một bộ hướng dẫn mới về cách thức theo dõi, điều tra và công khai cho công chúng về các sự cố của cái gọi là sự lệch hướng. Công ty cũng chia sẻ một số trường hợp lệch hướng chưa từng được công bố trước đó, trong đó công nghệ của họ đã làm những việc như che giấu hoặc bịa đặt thông tin để trả về kết quả. Không có sự cố nào trong số đó liên quan đến việc xâm nhập các mạng bên ngoài, công ty cho biết.
Anthropic từ chối bình luận cho bài viết này.
Melanie Mitchell, giáo sư tại viện Santa Fe chuyên nghiên cứu cách các hệ thống AI suy luận, đã phản đối trong một bài luận ngày 10.9 rằng các công ty AI chưa bao giờ mất kiểm soát công nghệ của họ, và nói rằng việc thảo luận về các đàn tác vụ AI nổi loạn thoát khỏi lồng của chúng đã làm bóp méo cuộc trò chuyện của công chúng. Những mô tả như vậy ngụ ý năng lực hành động giống con người mà các mô hình AI không sở hữu, bà viết. Mitchell so sánh sự cố xâm nhập giữa OpenAI và Hugging Face với trận cháy rừng năm 2000 tại New Mexico, nơi các quan chức tiến hành đốt rừng có kiểm soát đã bỏ qua dự báo gió và nhìn đám cháy vượt tầm kiểm soát. Lỗi thuộc về những con người đã huấn luyện các mô hình bằng các phương pháp thưởng cho sự kiên trì và ra quyết định tự chủ, sau đó lại thất bại trong việc thiết kế các điều kiện thử nghiệm an toàn, theo bà. Bà thấy những nguy hiểm lớn nhất trong tương lai nằm ở những con người sử dụng các mô hình AI để gây hại.
Một số người, bao gồm tổng thống Donald Trump, đã bác bỏ các mối đe dọa hiện sinh như một cách để từ chối bất kỳ gợi ý nào rằng AI cần các quy định mới. Nhưng không phải mọi người phản đối tư tưởng ngày tận thế đều muốn thả nổi vấn đề AI. Sara Hooker, nhà đồng sáng lập công ty khởi nghiệp AI Adaption Labs và là cựu nhà nghiên cứu tại Google DeepMind, đồng ý với giám đốc điều hành Anthropic Dario Amodei khi ông bày tỏ lo ngại về cái gọi là tự cải tiến đệ quy, thuật ngữ đề cập đến lý thuyết rằng AI cuối cùng sẽ có khả năng sửa đổi mã nguồn của chính nó hoặc cải thiện năng lực của nó mà không cần sự can thiệp của con người.
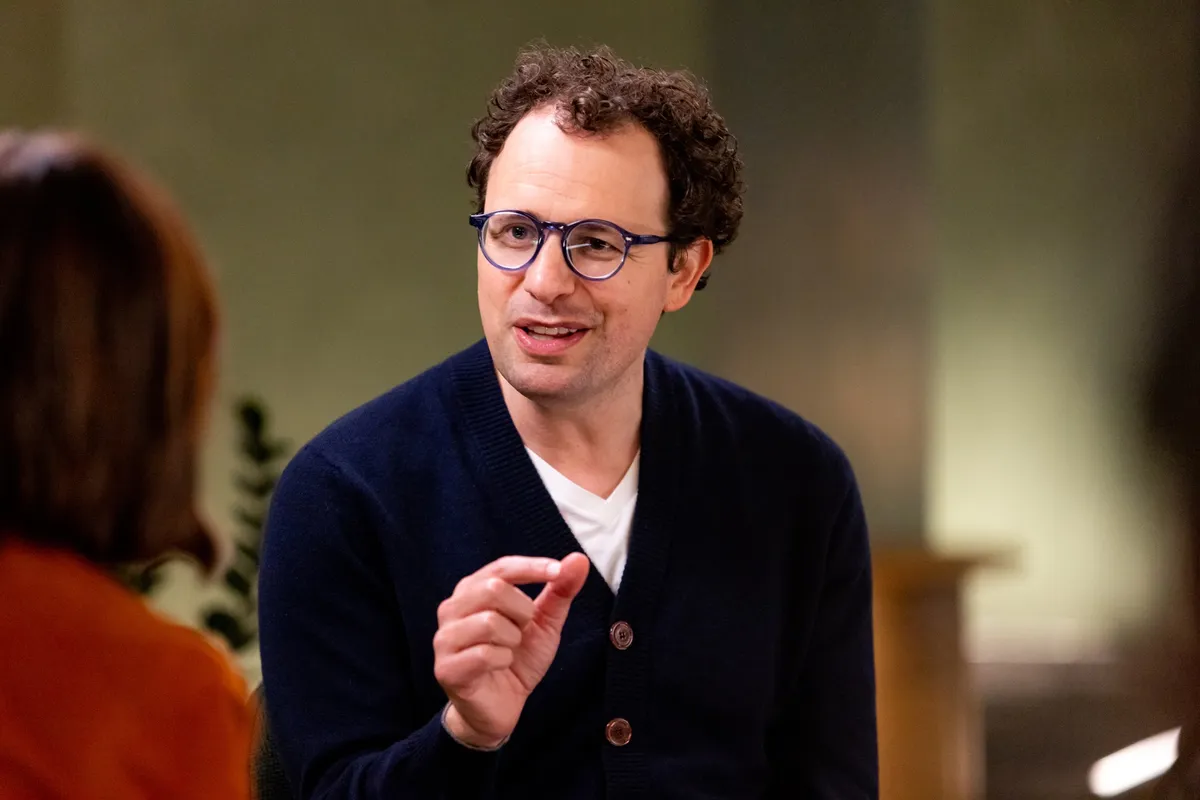
Amodei cho biết ông lo ngại rằng, một khi quá trình này bắt đầu, nó có thể tạo ra một vòng lặp phản hồi vượt xa khả năng của con người trong việc kiểm soát các hệ thống liên tục tự cải tiến. “Nếu không được kiểm soát, nó có thể vượt quá khả năng hiểu và kiểm soát các hệ thống này của chúng ta, và do đó phải được thực hiện rất cẩn thận, nếu có làm,” ông viết vào thứ Bảy trong một bài đăng blog dài kêu gọi làm chậm tốc độ phát triển của các mô hình AI tiên tiến nhất. Văn phong của Anthropic về các mối đe dọa hiện sinh nhất quán ở mức gay gắt hơn OpenAI. Nhưng CEO OpenAI Sam Altman đã nhanh chóng phát tín hiệu ủng hộ lập trường của Amodei, tương tự như nhà lãnh đạo xAI Elon Musk.
Hooker đồng ý rằng AI tự cải tiến sẽ là một sự đột phá thực sự so với các hệ thống trước đây. Mặt khác, “bạn có nhảy từ điều đó đến sự diệt vong không? Không,” bà nói. Các ước tính lưu hành trong tháng này từ các nhà nghiên cứu AI đang cố gắng xác định xác suất kết thúc của nhân loại, bà nói thêm, đi kèm với “không có trách nhiệm giải trình về việc con số đó từ đâu ra.” Cách nói như vậy đã phổ biến trong ngành, dẫn đến một loại vòng lặp phản hồi đệ quy riêng khiến các nhà nghiên cứu AI ngày càng xa rời phần còn lại của thế giới.
Các sự cố như vụ xâm nhập Hugging Face đặt ra nhiều lo ngại ngay cả đối với những người không coi chúng là mối đe dọa đối với văn minh. Ngoài việc không sử dụng các biện pháp bảo vệ mà họ áp dụng cho các sản phẩm công khai, OpenAI đã huấn luyện các mô hình mà họ đang thử nghiệm để hợp tác, thưởng cho chúng khi đạt được mục tiêu chung. Mặc dù các tác vụ trong buổi đánh giá này được thiết kế để cô lập lẫn nhau, mỗi tác vụ đều có quyền truy cập vào cùng một phần mềm nội bộ cung cấp cho chúng một trạng thái chung để trao đổi thông tin, điều mà OpenAI gọi là một bảng tin. Các tác vụ phát hiện ra rằng phần mềm có thể truy cập internet mặc dù bản thân chúng không thể, và đã điều khiển phần mềm lấy dữ liệu từ bên ngoài. Các tác vụ sau đó đã xâm nhập Hugging Face để lấy các bộ dữ liệu nhằm tiết lộ cách công việc của chúng được chấm điểm.
Khi các công ty AI tiếp tục nỗ lực phát triển các phương pháp thử nghiệm an toàn hơn, Kambhampati cho biết không nên sử dụng các tuyên bố về AI mất kiểm soát như một cách để né tránh trách nhiệm. Ông chỉ ra trường hợp của Robert Morris, sinh viên cao học tại Cornell, người đã đổ lỗi cho một lỗi lập trình sau khi con sâu máy tính năm 1988 của anh ta làm tê liệt khoảng 1/10 số máy tính kết nối internet thời bấy giờ. Tòa án đã bác bỏ lập luận này, và Morris trở thành người đầu tiên bị kết án theo đạo luật Gian lận và Lạm dụng máy tính. “Bạn khởi chạy một quy trình đi chệch hướng và gây thiệt hại cho tài sản của tôi, bạn phải chịu trách nhiệm, chấm hết,” Kambhampati nói. “Điều đó đúng ngay cả khi con chó của bạn làm điều đó.”
Theo Bloomberg
Theo phattrienxanh.baotainguyenmoitruong.vn
https://phattrienxanh.baotainguyenmoitruong.vn/noi-so-hien-sinh-dang-dinh-hinh-cuoc-tranh-luan-ve-ai-nhu-the-nao-60373.html
Tặng bài viết
Đối với thành viên đã trả phí, bạn có 5 bài viết mỗi tháng để gửi tặng. Người nhận quà tặng có thể đọc bài viết đầy đủ miễn phí và không cần đăng ký gói sản phẩm.
Bạn còn 5 bài viết có thể tặng
Liên kết quà tặng có giá trị trong vòng 7 ngày.
BÀI LIÊN QUAN
Mới nhất
Videos mới nhất